4 novembre 2026 · 11 min de lecture · AI agents · Architecture · Production
La carte mentale de l’agent IA : de l’idée à la production
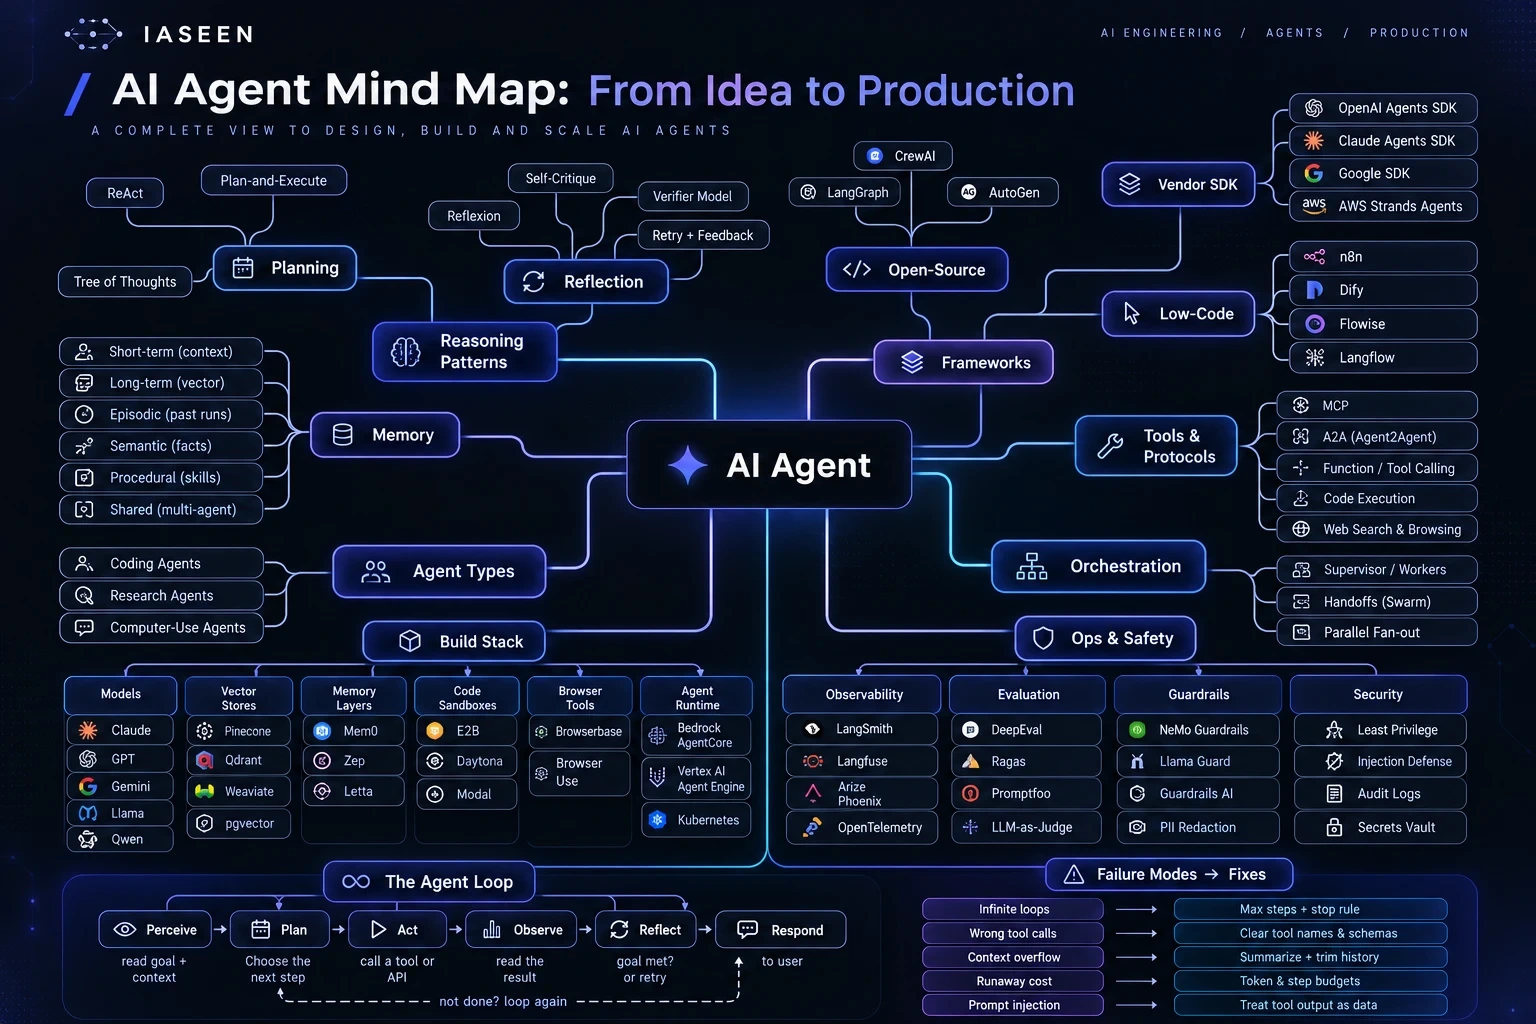
Une page qui montre toutes les décisions entre une idée d’agent et un agent en production : raisonnement, mémoire, outils, orchestration, stack et sécurité, avec les modes de défaillance que chacune appelle.
Yassine Aqejjaj · HEAD OF AI · Mis à jour le 4 novembre 2026
Un agent IA est un modèle qui tourne en boucle : percevoir, planifier, agir, observer, réfléchir, répondre. L’amener en production demande huit décisions autour de cette boucle : schéma de raisonnement, mémoire, type d’agent, framework, outils, orchestration, stack de construction, exploitation et sécurité. Cette carte les expose, avec les défaillances que chacune invite.
Qu’est-ce qu’un agent IA, et que couvre cette carte ?
Un agent est un modèle de langage placé dans une boucle et doté d’outils. Au lieu de répondre une seule fois, il lit un objectif, décide quoi faire, appelle un outil, regarde le résultat et décide à nouveau, jusqu’à juger la tâche terminée ou qu’une règle l’arrête. Cette boucle est la rangée du bas de la carte. Tout le reste est une décision à prendre autour d’elle.
Cette carte répond aux deux questions que toute équipe se pose : par où commencer, et qu’oublie-t-on ? Au centre, l’agent. Autour de lui, huit branches, chacune une famille de choix. En partant du haut à gauche : schémas de raisonnement, mémoire, types d’agents, stack de construction, exploitation et sécurité, orchestration, outils et protocoles, frameworks. Tout en bas, un tableau associe cinq défaillances courantes au remède qui fonctionne.
- Percevoir
- Planifier
- Agir
- Observer
- Réfléchir
- Répondre
Que se passe-t-il dans la boucle de l’agent ?
La boucle compte six étapes, et chacune peut échouer à sa manière. Les nommer est utile, car cela indique où placer une ligne de journal, une limite ou un test.
- Percevoir : lire l’objectif et le contexte. L’échec ici, c’est un contexte manquant ou démesuré.
- Planifier : choisir l’étape suivante. L’échec ici, c’est un plan qui ne correspond pas aux outils fournis.
- Agir : appeler un outil ou une API. L’échec ici, c’est le mauvais outil ou les mauvais arguments.
- Observer : lire le résultat. L’échec ici, c’est faire confiance à un résultat vide, faux ou hostile.
- Réfléchir : se demander si l’objectif est atteint ou s’il faut réessayer. L’échec ici, c’est boucler sans progrès.
- Répondre : répondre à l’utilisateur. L’échec ici, c’est une réponse qui semble finie alors que le travail ne l’est pas.
Quel schéma de raisonnement choisir ?
La carte sépare le raisonnement en deux. La planification regroupe ReAct, Plan-and-Execute et Tree of Thoughts. La réflexion regroupe Reflexion, l’auto-critique, un modèle vérificateur distinct, et le réessai avec retour d’information.
Ma règle empirique : commencer par le schéma le plus simple qui fonctionne, et n’ajouter de la structure que lorsqu’une défaillance l’exige. ReAct, où le modèle alterne réflexion et action, suffit pour beaucoup de tâches. Plan-and-Execute mérite sa place sur les tâches longues, car écrire tout le plan d’abord rend la dérive visible. Tree of Thoughts vaut rarement son coût en dehors des problèmes de recherche difficiles.
C’est sur la réflexion que les équipes dépensent souvent trop. Demander à un modèle de critiquer sa propre réponse coûte des jetons et il tombe souvent d’accord avec lui-même. Pour tout ce qui a des conséquences, je préfère un contrôle qui ne partage pas les angles morts du générateur : un modèle vérificateur, une règle ou un test.
De quels types de mémoire un agent a-t-il besoin ?
La carte en liste six, et elles répondent à des questions différentes. Mieux vaut se demander ce que l’agent doit retenir, et pour combien de temps, avant de choisir un stockage.
- La mémoire à court terme est la fenêtre de contexte : la tâche en cours, rien de plus.
- La mémoire à long terme réside dans une base vectorielle, pour les connaissances à retrouver plus tard.
- La mémoire épisodique enregistre les exécutions passées, pour que l’agent apprenne de ce qui s’est produit.
- La mémoire sémantique conserve des faits stables sur les utilisateurs et le domaine.
- La mémoire procédurale conserve des compétences : comment faire quelque chose, réutilisable d’une tâche à l’autre.
- La mémoire partagée permet à plusieurs agents de lire et d’écrire le même état.
Pourquoi la mémoire demande-t-elle de la gouvernance, pas seulement du stockage ?
La plupart des problèmes de mémoire ne sont pas des problèmes de stockage. Ce sont des problèmes de confiance : d’où vient ce fait, est-il toujours vrai, et qui a le droit de le voir ? Une mémoire qui ne sait pas répondre finira par glisser dans un prompt un fait périmé ou privé.
C’est l’idée d’ORBIT, le moteur de contexte et de mémoire gouverné que je construis : le contexte doit être traçable et daté, surtout dans les travaux longs et multi-agents. Quel que soit le stockage choisi, conservez la provenance et une date à côté du contenu, et décidez à l’avance ce qui peut être oublié.
Quel type d’agent construisez-vous ?
La carte en nomme trois : agents de code, agents de recherche et agents d’usage d’ordinateur. Ils diffèrent moins par l’intelligence que par les dégâts qu’une mauvaise action peut causer. Un agent de recherche lit. Un agent de code écrit des fichiers et lance des commandes. Un agent d’usage d’ordinateur clique dans de vraies applications, ce qui représente la plus large surface d’action des trois.
Choisissez d’abord le type, car il fixe le niveau de cloisonnement, de relecture et d’approbation dont vous aurez besoin ensuite. J’ai abordé le cas des agents de code dans mon article sur l’autonomie méritée : l’autonomie doit être accordée pas à pas, à mesure que les preuves s’accumulent.
Framework open source, SDK d’éditeur ou low-code ?
Les frameworks sont la branche qui compte le plus de logos, donc la plus facile pour s’y perdre. Pensez en trois familles : les frameworks open source comme LangGraph, CrewAI et AutoGen ; les SDK d’éditeurs, venant des fournisseurs de modèles et des plateformes cloud ; et les outils low-code comme n8n, Dify, Flowise et Langflow. Le tableau ci-dessous est ma propre simplification, pas un benchmark.
| Critère | Framework open source | SDK d’éditeur | Outil low-code |
|---|---|---|---|
| Contrôle du comportement | Élevé : vous possédez le graphe | Moyen : vous suivez le modèle de l’éditeur | Faible à moyen : vous configurez des blocs |
| Rapidité du premier prototype | Moyenne | Élevée, si vous utilisez déjà cet éditeur | La plus élevée |
| Coût de changement | Moyen : le code est à vous, les schémas se retrouvent ailleurs | Élevé : concepts et traçage propres à l’éditeur | Élevé : les flux vivent dans l’outil |
| Qui peut construire | Ingénieurs | Ingénieurs | Ingénieurs et métiers techniques |
| Meilleur usage | Plateformes sur mesure et durables | Équipes standardisées sur un fournisseur | Automatisations internes et essais rapides |
Comment les outils et protocoles relient-ils un agent au monde ?
Un agent n’est capable que des outils qu’il peut appeler. La carte les regroupe en appel de fonctions ou d’outils, exécution de code, recherche et navigation web, et deux protocoles : MCP, qui standardise la façon dont un agent accède aux outils et aux données, et A2A, qui standardise la façon dont les agents se parlent.
Deux points pratiques. D’abord, une description d’outil fait partie de votre prompt : des noms clairs et des schémas stricts préviennent toute une classe de mauvais appels. Ensuite, l’exécution de code et la navigation doivent se faire dans un bac à sable, jamais sur la machine qui détient vos secrets. Les protocoles réduisent le travail d’intégration, mais ne décident pas de ce qu’un agent a le droit de faire. C’est une question de politique, qui demande sa propre couche.
Comment orchestrer plusieurs agents ?
La carte montre trois schémas : un superviseur qui délègue à des exécutants, des passages de relais où un agent confie la tâche à un autre, et un éventail parallèle où plusieurs agents travaillent en même temps avant que les résultats soient fusionnés.
Mon conseil est celui de tout système distribué : ne répartissez pas un problème entre plusieurs agents tant qu’un seul agent n’y a pas clairement échoué. Chaque agent supplémentaire ajoute de la coordination, du coût et de nouvelles façons d’échouer. Quand la répartition se justifie, un superviseur est le schéma le plus simple à raisonner et à tracer.
Que contient la stack de construction ?
La branche stack liste six couches : les modèles (Claude, GPT, Gemini, Llama, Qwen), les bases vectorielles (Pinecone, Qdrant, Weaviate, pgvector), les couches de mémoire (Mem0, Zep, Letta), les bacs à sable de code (E2B, Daytona, Modal), les outils de navigation (Browserbase, Browser Use) et un runtime d’agent (plateformes d’agents cloud, ou Kubernetes si vous l’exploitez vous-même).
Deux choix méritent du soin. Gardez le modèle derrière une interface, pour que changer de fournisseur soit un changement de configuration et non une réécriture. Et traitez le runtime comme une décision produit : il détermine comment vous déployez, dimensionnez, isolez et observez vos agents.
Comment exploiter un agent en sécurité ?
La branche exploitation compte quatre couches, et les équipes les construisent parfois dans le mauvais ordre. Elles commencent par les garde-fous et ajoutent l’évaluation tard. Je ferais l’inverse.
- Observabilité : des traces de chaque étape et de chaque appel d’outil, avec des outils comme LangSmith, Langfuse, Arize Phoenix et OpenTelemetry. On ne corrige pas ce qu’on ne peut pas rejouer.
- Évaluation : un jeu fixe de tâches noté automatiquement, avec des outils comme DeepEval, Ragas et Promptfoo, ou un LLM utilisé comme juge. C’est ce qui permet de changer un prompt sans crainte.
- Garde-fous : des contrôles en entrée et en sortie, comme NeMo Guardrails, Llama Guard, Guardrails AI et le masquage des données personnelles.
- Sécurité : moindre privilège, défense contre l’injection de prompt, journaux d’audit et coffre à secrets. Cette couche décide de ce que l’agent peut faire, quelle que soit sa bonne conduite.
Quels modes de défaillance faut-il anticiper ?
Le tableau en bas de la carte associe cinq défaillances à un remède. J’ai ajouté une troisième colonne, car un remède n’aide que si l’on remarque la défaillance tôt.
| Mode de défaillance | Remède de la carte | Comment le détecter tôt |
|---|---|---|
| Boucles infinies | Nombre maximal d’étapes et règle d’arrêt | Alerter sur les exécutions qui atteignent la limite |
| Mauvais appels d’outils | Noms d’outils et schémas clairs | Suivre le taux d’erreur d’appel d’outil dans les traces |
| Débordement du contexte | Résumer et réduire l’historique | Journaliser les jetons par étape et suivre la tendance |
| Coût qui s’emballe | Budgets de jetons et d’étapes | Coût par exécution, avec alerte sur les valeurs extrêmes |
| Injection de prompt | Traiter la sortie d’un outil comme une donnée, jamais comme une instruction | Inclure des cas d’injection dans le jeu d’évaluation |
Dans quel ordre le construire ?
La carte montre tout le territoire. Elle n’indique pas l’ordre, et c’est l’ordre qui fait gagner les projets. Voici la séquence que je suivrais aujourd’hui.
- Écrire d’abord la tâche et la règle d’arrêt : ce qui est terminé, et quand l’agent doit abandonner.
- Construire un agent avec deux ou trois outils et du traçage dès le premier jour.
- Créer le jeu d’évaluation avant d’ajouter des fonctionnalités, pour mesurer chaque changement.
- Ajouter de la mémoire seulement quand une défaillance mesurée l’exige, avec sa provenance.
- Ajouter garde-fous, permissions et approbations en proportion de la surface d’action.
- Ajouter l’orchestration en dernier, et seulement quand un agent seul a clairement atteint sa limite.
QUESTIONS FRÉQUENTES
Qu’est-ce qu’un agent IA ?
Un agent IA est un modèle de langage exécuté en boucle avec accès à des outils. Il lit un objectif, décide quoi faire, appelle un outil, observe le résultat et recommence jusqu’à ce que la tâche soit terminée ou qu’une règle d’arrêt mette fin à l’exécution.
Quelles sont les étapes de la boucle de l’agent ?
Percevoir, planifier, agir, observer, réfléchir et répondre. Si la tâche n’est pas terminée, l’agent reboucle. Chaque étape peut échouer différemment, donc chacune doit avoir sa journalisation, ses limites et ses tests.
Quelle différence entre MCP et A2A ?
MCP standardise la façon dont un agent se connecte aux outils et aux données. A2A standardise la communication entre agents. Aucun ne décide de ce qu’un agent a le droit de faire : cela demande une couche de politique et de permissions distincte.
Comment empêcher un agent IA de boucler indéfiniment ?
Fixez un nombre maximal d’étapes et une règle d’arrêt explicite, ajoutez des budgets de jetons et de coût, et alertez sur les exécutions qui atteignent la limite. La réflexion doit être contrôlée par quelque chose qui ne partage pas les angles morts du générateur.
Faut-il commencer par un système multi-agents ?
Non. Commencez par un agent et quelques outils, mesurez où il échoue, et ne passez à plusieurs agents que lorsqu’un agent seul a clairement atteint sa limite. Chaque agent supplémentaire ajoute du coût de coordination et de nouveaux modes de défaillance.
RÉSULTATS
8
décisions autour de la boucle, du raisonnement à l’exploitation
6
étapes dans la boucle de l’agent
4
couches d’exploitation : observabilité, évaluation, garde-fous, sécurité
5
modes de défaillance récurrents, chacun associé à un remède
LE CODE
À LIRE AUSSI
Les chiffres viennent de résultats clients validés et de mon rôle chez Devoteam. Les projets GitHub sont des bêtas publiques.